IvorySQL 多模融合实战:pg_textsearch + pgvector 上生产前,必踩的 7 个坑
企业智能知识库多模融合系列(二):在 IvorySQL 5.4 上实测 pg_textsearch + pgvector 混合检索,复现并拆解上生产前必踩的 7 个坑,附完整 SQL 脚本与复现步骤。
Wei Bo
Deputy Secretary-General
本文为企业智能知识库多模融合系列(二):多模检索落地排障, IvorySQL 多模融合实战系列续篇,基于 IvorySQL 5.4(PostgreSQL 18.4)版本,在 Windows 11+Docker Desktop 标准化容器环境中完成全量实测。所有验证依托 pg_textsearch 1.4.0、pgvector 0.8.5 最新稳定组合开展,7 类核心问题均成功复现,配套 8 组 SQL 脚本、9 张实测截图均可溯源重跑,动态浮动数据也已逐一标注,确保内容真实可信、可落地、可复现。
不同于常规技术评测,上篇文章验证了多类扩展能否共存协同,本文聚焦生产落地核心痛点,化身上生产前置排障清单,直面 pg_textsearch 与向量混合检索场景的各类隐藏坑点,拆解问题成因、给出可行修复方案,解答开发者与运维者真正关心的**「敢不敢直接上生产」**问题。
〇、先说清楚四件事
0.1 这篇的版本底座
| 项 | 值 |
|---|---|
| 数据库 | IvorySQL 5.4(内核 PostgreSQL 18.4) |
| 容器 | ivorysql-ts140,端口 5436(见附录 C,一条命令起) |
| pgvector | 0.8.5(HNSW) |
| pg_textsearch | 1.4.0(上游最新稳定 GA;1.0.0 于 2026-03 正式发布) |
| 数据集 | 12 篇 PostgreSQL 运维短文(kb_pgops 表,384 维向量,完整清单见 0.4) |
0.2 关于版本,简单交代两句
本系列上篇(系列一,已发表)的实验是在 pg_textsearch 0.6.1(预发布版)上做的——当时我 Dockerfile 里的版本没有跟着上游更新,本文把全部实验在 1.4.0 上重新跑了一遍,两个结果:
-
BM25 的检索行为两版逐位一致——5 个查询的 Top5、打分小数点后四位都相同。这对你的实际意义是:如果生产库要从 0.6.1 升到 1.4.0,检索结果不会变,已有的评测结论不用推翻重跑。
-
有一个坑在新版被修掉了:0.6.1 上"索引看着活着、查询却返回 0 行"的静默失效,在 1.4.0 上连续重启两次都复现不出来。这个坑没有从文中删掉,而是挪到了文末的「附录 D」——它本身就是"为什么要升级"的最好证据。
剩下 7 个坑全部在 1.4.0 上实测仍然成立。它们的根大多不在 pg_textsearch 自己身上,而在 PostgreSQL 的规划器、分词器和部署方式上——这也是它们不太可能被版本升级"顺手修掉"的原因。
0.3 七个坑速览
| # | 坑 | 症状(你会看到什么) | 一句话解法 |
|---|---|---|---|
| 1 | 多模扩展要自己装,顺序反了会起不来 | CREATE EXTENSION 报 could not access file;文件没到位就先改预加载,数据库 FATAL 罢工 | 先放 .so → 再改预加载 → 最后重启,顺序不能乱 |
| 2 | simple 配置对中文"零词位" | 纯中文查询恒返回 0 行 | 换 zhparser / pg_jieba / pg_bigm |
| 3 | 一个标量子查询让 HNSW 白建 | 计划里冒出 InitPlan,退化成 Seq Scan + Sort | 向量用绑定参数 $1::vector 传入 |
| 4 | w=1 不等于走 BM25 索引 | 榜单出现 [2,3,4,5,1] 这种"不该在的人" | CTE 里显式剔除零分候选 |
| 5 | 建了 HNSW 却走 Seq Scan | idx_scan = 0 | 这是规划器在省钱,不是索引失效 |
| 6 | HNSW 维护与容量 | 想改维度、VACUUM INDEX 报错、磁盘估少了 | 改维度必重建;容量按实测每行字节数 |
| 7 | 上线后没得看 | pg_stat_statements 有但没开;死元组悄悄堆积 | 预加载启用 + 阈值巡检 |
每个坑都按同一套结构写:症状 → 根因 → 解法 → 验证 → 记住一句。 救火的直接翻「解法」;想系统避坑的从头读,大约 20 分钟。
先说清楚:这些坑算在谁头上。 这 7 个坑里,坑 1 是部署顺序问题(先放扩展文件还是先改预加载);坑 2(分词器)、坑 3(规划器)、坑 5(成本估算)、坑 7(统计视图)源自 PostgreSQL 内核的通用机制;坑 4、坑 6 来自 pg_textsearch / pgvector 等生态扩展自身的实现——换成任何一款 PostgreSQL 系数据库,这些坑一个都躲不掉,不是 IvorySQL 独有的问题。反过来讲,正因为 IvorySQL 完整兼容 PostgreSQL 扩展生态(本文两个扩展在 5.4 上都是一次编译通过),PG 生态这些年积累的排障经验才能在这里直接复用——这是兼容性带来的红利,不是负担。
0.4 实验表、测试文档集和两个索引:后面反复出现的名字先认个脸
全文反复出现的 kb_pgops 表、12 篇测试文档和三个索引,都是附录 C 第 ③ 步由 code/kb_pgops_init.sql 一次性建好的(先建表、再建两个索引、最后灌 12 行数据),后面所有实验直接复用。先看建表 DDL:
CREATE TABLE kb_pgops (
    id SERIAL PRIMARY KEY,          -- 主键索引 kb_pgops_pkey(btree)是这一句自动建的
    title VARCHAR(300),
    content TEXT,
    category VARCHAR(50),
    embedding vector(384),          -- 384 维向量列,依赖 pgvector
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
灌进去的 12 篇文档,是下面这套 PostgreSQL 运维短文(每篇正文 180~220 字,全文在 code/kb_pgops_init.sql;分类刻意覆盖运维的不同侧面,好让"关键词精确命中"和"主题相近但用词不同"能拉开差异):
| id | 分类 | 标题 |
|---|---|---|
| 1 | 备份恢复 | pg_dump 逻辑备份与恢复 |
| 2 | 索引维护 | B-tree 索引维护与 REINDEX |
| 3 | VACUUM | VACUUM 与 autovacuum 调优 |
| 4 | 监控 | pg_stat_statements 慢查询定位 |
| 5 | 锁 | 锁等待与死锁排查 |
| 6 | 复制 | 流复制与主备切换 |
| 7 | 备份恢复 | WAL 归档与 PITR 时间点恢复 |
| 8 | 参数调优 | shared_buffers 与内存调优 |
| 9 | 分区 | pg_partman 时序数据分区 |
| 10 | 查询计划 | EXPLAIN ANALYZE 查询计划解读 |
| 11 | 参数调优 | checkpoint 与 bgwriter 调优 |
| 12 | 安全 | pg_hba.conf 连接认证安全 |
embedding 列的 384 维向量不是大模型生成的语义向量,而是数据集生成脚本对文档分词后做 token-hash(MD5、固定 seed=42)拼出、并已逐行固化在 kb_pgops_init.sql 里的可复现伪向量:这样实验零外部依赖,不需要任何模型服务,任何人重跑都得到同一组数字;代价是它没有真正的语义泛化能力,所以本文只演示机制、不做检索能力评测(这条边界在附录 A.1 有完整声明,严肃评测请换外部标准数据集)。
配套 5 个测试查询(坑 4、附录 A 会反复引用 Q1~Q5;gold = 人工标注"应当命中哪些 id"):
| 查询 | 查询词 | gold | 设计意图 |
|---|---|---|---|
| Q1 | pg_dump 备份 | [1] | 精确术语,BM25 强项 |
| Q2 | backup WAL 归档 恢复(中英混合) | [1, 7, 6] | 宽泛语义、跨文档 |
| Q3 | REINDEX 索引 性能 | [2, 3, 10] | 中英混合边界,坑 4 的现场 |
| Q4 | pg_locks 锁 死锁 | [5] | 精确术语 |
| Q5 | checkpoint 太频繁 IO 抖动怎么办,和 WAL 归档、主备切换有关系吗 | [11] | 一次问多个子话题,考排名 |
两个索引分别建在正文列和向量列上:
-- 全文检索索引(坑 2、坑 4、附录 D 的主角),访问方法 bm25 来自 pg_textsearch
CREATE INDEX kb_pgops_bm25_idx ON kb_pgops USING bm25(content) WITH (text_config='simple');

-- 向量近似检索索引(坑 3、坑 5、坑 6 的主角),访问方法 hnsw 来自 pgvector
CREATE INDEX kb_pgops_hnsw_idx ON kb_pgops USING hnsw (embedding vector_cosine_ops)
    WITH (m = 16, ef_construction = 64);
| 索引名 | 访问方法 | 来源 | 用途 |
|---|---|---|---|
| kb_pgops_pkey | btree | 主键自动建 | 按 id 取行(坑 3 的 InitPlan 走的就是它) |
| kb_pgops_bm25_idx | bm25 | 上面第 1 条 CREATE INDEX | 关键词全文检索 |
| kb_pgops_hnsw_idx | hnsw | 上面第 2 条 CREATE INDEX | 向量相似度检索 |
三个索引建好后,执行下面这条 psql 元命令可一次性确认它们都在(含访问方法与体积的完整输出见图 8,坑 6 还会用同一条命令算索引体积);至于"计划里出现 pkey 算不算用上了 HNSW",需要结合执行计划才能讲清,留到坑 3。
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c "\di+ kb_pgops*"
预期列出 3 行(实测输出,体积口径见图 8):
Name        | Type  | Access method | Size
--------------------+-------+---------------+------
 kb_pgops_bm25_idx  | index | bm25          | 16 kB
 kb_pgops_hnsw_idx  | index | hnsw          | 32 kB
 kb_pgops_pkey      | index | btree         | 16 kB
一、坑 1:多模扩展要自己装,而且装的顺序反了会让数据库起不来
症状
IvorySQL 官方镜像 registry.highgo.com/ivorysql/ivorysql:5.4-ubi8 聚焦的是数据库内核与 Oracle 兼容能力,PostgreSQL 生态的多模扩展需要按自己的需求另行安装——这与 PostgreSQL 官方镜像的做法一致(系列第一篇也验证过这一点)。第一次装 pg_textsearch,通常要经历两步。
先装:
CREATE EXTENSION pg_textsearch;
ERROR:  could not access file "pg_textsearch": No such file or directory
按 PostgreSQL 的惯例去配 shared_preload_libraries、然后重启——
FATAL: could not access file "pg_textsearch": No such file or directory
数据库直接起不来了,连 psql 都连不上。
根因
两件独立的事叠在了一起:
-
扩展文件需要先编译进文件系统。 这不是 IvorySQL 的短板,而是"内核保持精简、能力按需组合"的取舍——好处恰恰是扩展版本由我们自己说了算:本文直接用了上游最新的 pg_textsearch 1.4.0,不必被镜像里某个固定版本钉死。而且 PG 生态扩展在 IvorySQL 5.4 上编译安装没有任何障碍,本文的 pgvector 与 pg_textsearch 都是一次编译通过(完整 Dockerfile 见附录 C)。
-
shared_preload_libraries 是启动契约,不是愿望清单。 这条是 PostgreSQL 的通用机制,与 IvorySQL 本身无关:数据库启动时会挨个加载名单里的库,缺一个就整体罢工——它绝不会"先跳过、以后再说"。
所以这个坑的实质不是"要自己装",而是顺序:文件还没到位就先写了预加载,数据库立刻起不来。
顺带说一句版本差异(这次要夸的是 pg_textsearch 上游):0.6.1 时代这两条报错一模一样、且都不带任何提示;1.4.0 把第一条改得相当友好了:
ERROR:  pg_textsearch library not loaded.
        Add pg_textsearch to shared_preload_libraries and restart.
还附赠版本一致性校验(库版本和 SQL 脚本版本对不上会明确报错)。但"必须预加载"这个要求本身没变——所以坑还在,只是现在报错会直接告诉你缺什么、该怎么做。
解法
顺序不能乱,三步:
# ① 先把扩展文件放进文件系统(编译安装)
#    最小集只装本文用到的两个:pgvector + pg_textsearch
#    完整 Dockerfile 见附录 C / 06_生产级部署_Dockerfile/

# ② 再改预加载配置(保留原有项,追加新的)
#    等号右侧前 3 项 gb18030_2022、liboracle_parser、ivorysql_ora 是镜像出厂自带的原有项
#    (依次为 GB18030-2022 国标字符集、Oracle 兼容解析器、Oracle 兼容层),原样保留不要删;
#    只在末尾追加第 4 项 pg_textsearch。本文容器改完后的实测值:
#    shared_preload_libraries = 'gb18030_2022, liboracle_parser, ivorysql_ora, pg_textsearch'

# ③ 最后重启
docker restart ivorysql-ts140
为什么强调“保留原有项”:shared_preload_libraries 是整体覆盖、不是增量追加——如果只写 pg_textsearch,前 3 项出厂库会被一起挤掉,IvorySQL 的国标字符集与 Oracle 兼容能力随之失效。改动前可以先跑 SHOW shared_preload_libraries; 把这 3 个原有项原样抄下来,再在末尾追加新库。
如果已经 FATAL 起不来了:把配置改回原值让库先起来 → 补装 .so → 再按 ①②③ 来一遍。
不想每次都编译:把附录 C 的 Dockerfile 固化成自己的基础镜像,构建一次、团队长期复用。也期待社区后续推出预置多模扩展的镜像变体,把第 ① 步彻底省掉。
验证
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c \
  "SELECT name, default_version, installed_version FROM pg_available_extensions WHERE name IN ('vector','pg_textsearch') ORDER BY name;" -c \
  "SHOW shared_preload_libraries;"
第一条应返回 2 行扩展记录(installed_version 有值才算真装上),第二条应在预加载名单里看到 pg_textsearch。第一条返回 0 行 = 第 ① 步没做成;两行扩展都在但 CREATE EXTENSION 仍失败 = 第 ②③ 步漏了。
本文容器实测(图 1):installed_version 两列都有值,说明真的装上了;pg_textsearch 也已在 shared_preload_libraries 预加载名单中。
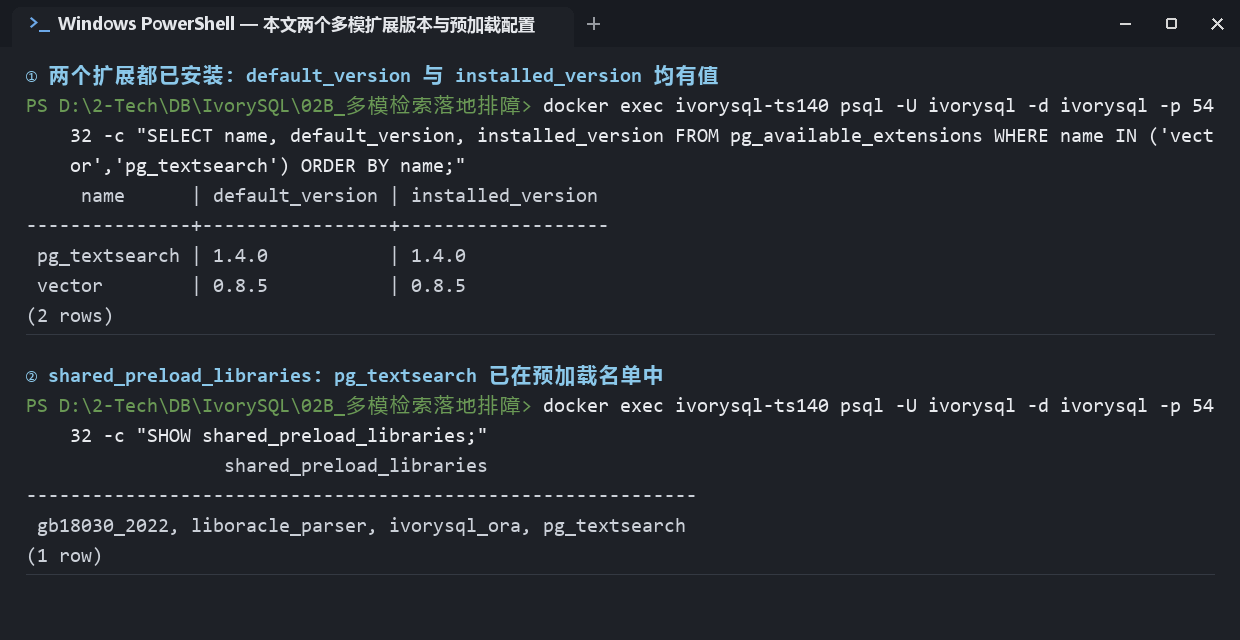
图 1:扩展版本与预加载配置实测(sql/00_env_check.sql 前两项)
记住一句
shared_preload_libraries 是"启动契约"——写上去的库必须存在,否则数据库宁可不起。这条是 PostgreSQL 的通用机制,与 IvorySQL 本身无关;要自己装扩展也不是 IvorySQL 的短板,别把账算错地方。
二、坑 2:simple 配置对中文"零词位"
症状
跑一条纯中文查询,BM25 路恒返回 0 行,什么都没匹配到。你可能以为索引坏了——其实索引好好的,只是它从头到尾就没看见中文。
根因
先亲眼看看索引到底"看见"了什么:
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c \
  "SELECT to_tsvector('simple','pg_dump 逻辑备份与恢复') AS probe1;" -c \
  "SELECT to_tsvector('simple','逻辑备份与恢复') AS probe2;"
实测输出见图 2:第一条里,中文连续串一个词位都没剩下(只剩 pg/dump 两个英文 token);第二条纯中文,直接是空的。
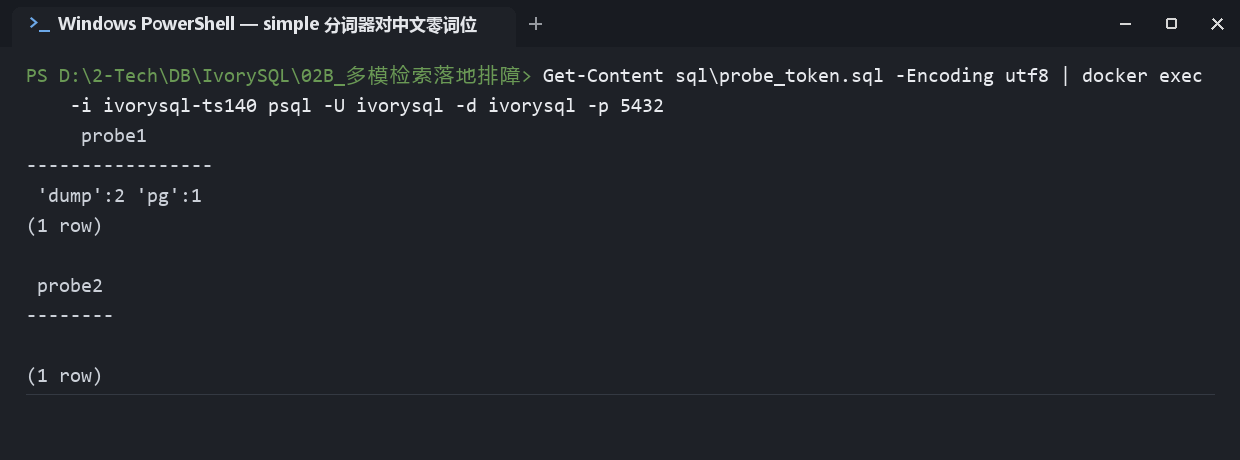
图 2:to_tsvector 实测——混排英文还剩两个词位,纯中文返回空
备注:这不是"中文分得差",是这个配置下根本不产出中文词位。PostgreSQL 全文检索是「parser 切 token → dictionary 处理 → configuration 组合」的机制,simple 意为"只按空白/标点切、不查词典"——英文天然按空格分词所以够用,中文连续书写就全灭。结论只针对 simple 配置,不等于"PostgreSQL 不能检索中文"。
一个连带效应值得知道:pg_dump 被切成了 pg、dump 两个词。于是只含 pg 的文档(pg_partman、pg_locks)也能拿到 BM25 分数——这解释了后文很多"为什么这篇也匹配上了"。
再挖一层:中文为什么连一个 token 都不是
换 ts_debug 看 parser 的分类结果,比只看 to_tsvector 输出清楚得多。跑这一条(输出见下方图 3 上半部分):
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c \
  "SELECT alias, token, lexemes FROM ts_debug('simple','pg_dump 逻辑备份与恢复');"
结果里中文整段被归为 blank(非词字符)——不是"切出了一个词但词典不认",而是压根没被当成词(图 3 上半部分:blank | 逻辑备份与恢复)。
判定"哪些字符算一个词"的是 parser 的字符分类,它取决于数据库编码与 lc_ctype。本文容器的实测值(图 3 下半部分):
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c \
  "SHOW server_encoding;" -c "SELECT datcollate, datctype FROM pg_database WHERE datname = current_database();"
SQL_ASCII + C 的组合下,中文字符不被识别为字母,直接落进 blank,于是零词位。
这套 SQL_ASCII + C 不是本文手工配置出来的,而是 IvorySQL 官方镜像初始化数据簇(initdb)时的集群级默认值:连不允许修改的模板库 template0 都是 SQL_ASCII + C;业务库 ivorysql 建库时没有显式指定编码与 locale,便沿模板原样继承。后面「验证」里的 zh_probe 之所以是 UTF8,正是因为建库时显式写了 ENCODING 'UTF8' LC_CTYPE 'en_US.utf8'。想一次看清自己实例里每个库的编码来历,跑这一条:
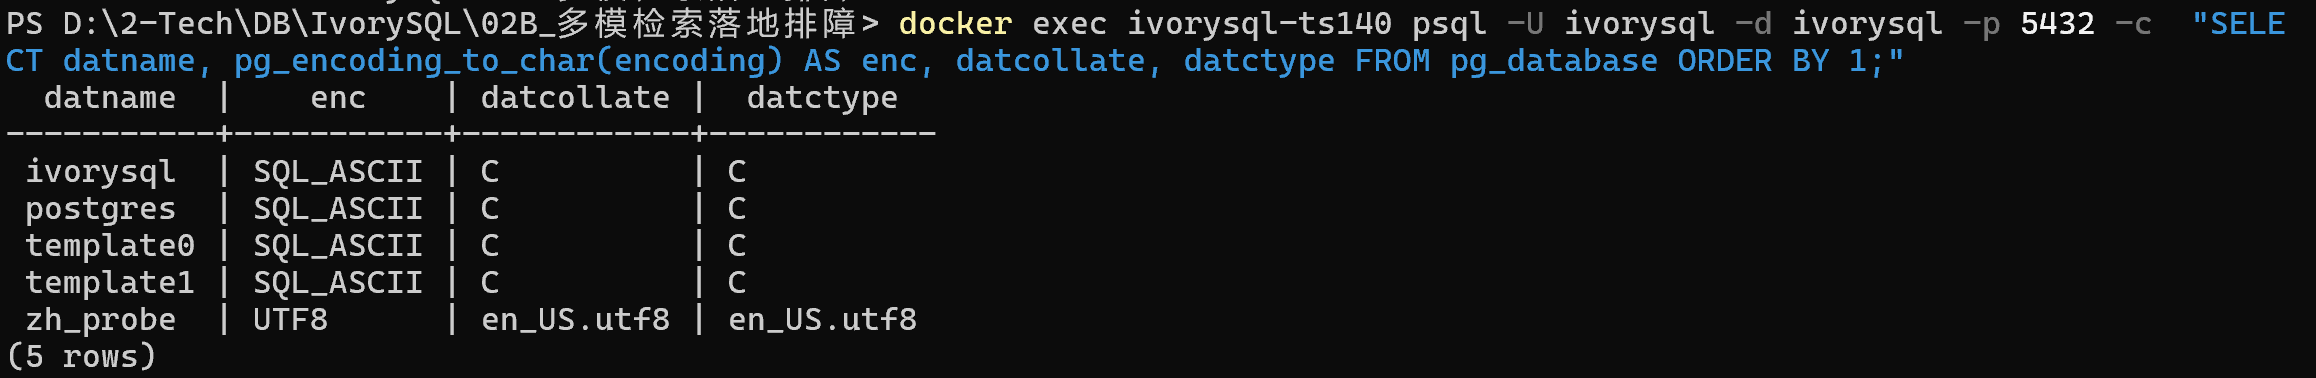
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c \
  "SELECT datname, pg_encoding_to_char(encoding) AS enc, datcollate, datctype FROM pg_database ORDER BY 1;"
本文容器实测:template0、template1、postgres、ivorysql 四行全部是 SQL_ASCII | C | C,只有显式指定编码/locale 创建的 zh_probe 一行是 UTF8 | en_US.utf8 | en_US.utf8——默认库无一例外,正是“集群默认、非手工配置”的直接证据;如果你的实例这四行是 UTF8,说明镜像或建库环节已显式指定过编码,坑 2 的现象要以你自己的查询结果为准。
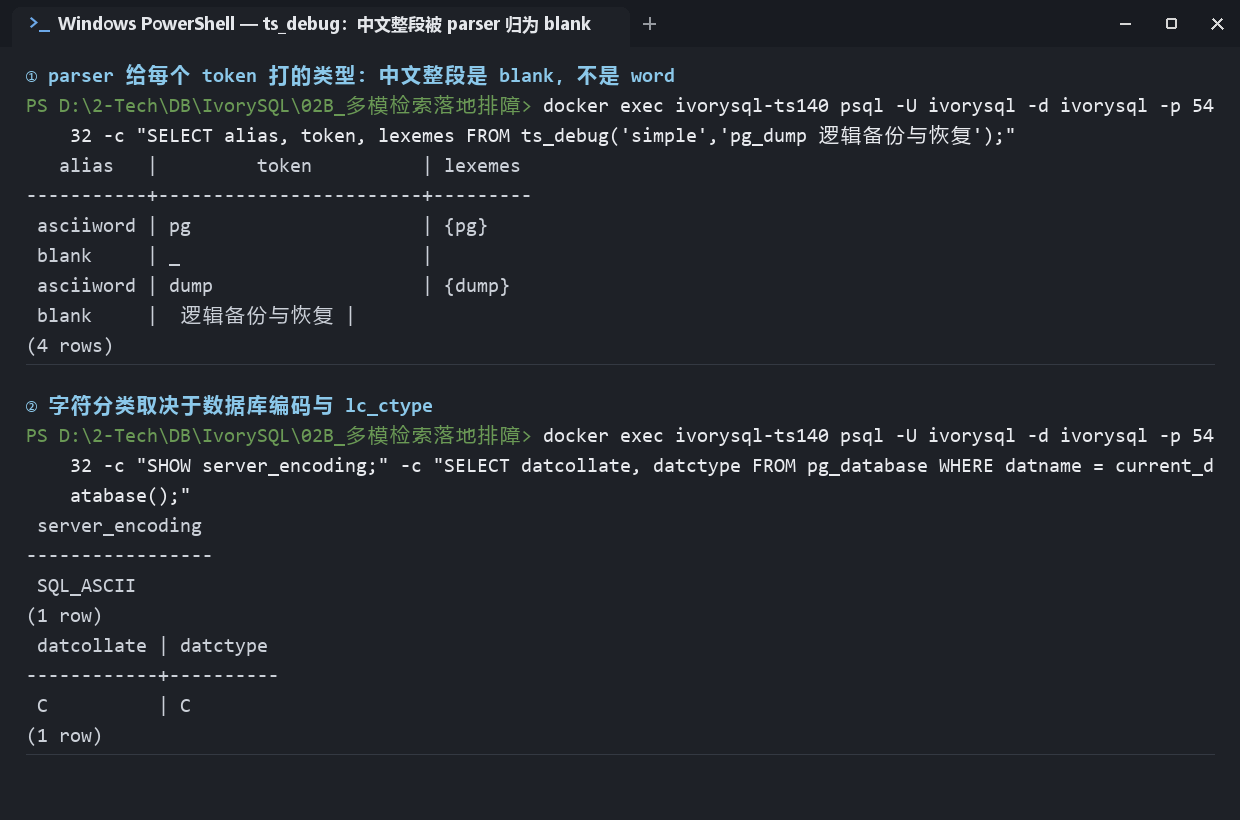
图 3:坑 2 实证——parser 给中文整段打的类型是 blank;SQL_ASCII + C 就是零词位的环境前提
所以在你自己的环境复跑,现象可能不同:
| 环境 | simple 下的中文表现 |
|---|---|
| SQL_ASCII + C(本文容器,实测);镜像 initdb 集群默认,非手工配置 | 整段归 blank,零词位 |
| UTF-8 + C locale(机制推断,未实测) | 多半仍是零词位 |
| UTF-8 + en_US.utf8 locale(实测,附库 zh_probe,见「验证」节) | 中文成为 word,被 simple 词典整串保留成一个词位(实测 '逻辑备份与恢复':1)——只有整串完全相等才命中,检索依然不可用,但现象是"一个超长词位"而不是空 |
三种环境现象不同,结论相同:simple 处理中文不可用。想知道自己属于哪一种,别猜,跑上面那条 ts_debug 看 alias 列。
解法
中文语料必须换分词方案,三选一(都是 PG 生态的成熟方案):
| 方案 | 特点 | 适用 |
|---|---|---|
| zhparser | 基于 scws,词典分词 | 通用中文 |
| pg_jieba | jieba 分词 | 通用中文,社区活跃 |
| pg_bigm | 2-gram,无需词典 | 专有名词多、新词多(系列第一篇已验证可用) |
换完配置后重建 BM25 索引,新词位才会生效。
注(范围说明):zhparser / pg_jieba 的实际编译安装与分词效果本文未逐一实测(需编译 SCWS 等分词引擎),选型方向如上、按你的语料落地即可;三者中 pg_bigm 已在系列一验证可用。本文「验证」节用同实例换编码的附库,证的是根因(编码/locale 决定中文是否出词位),不是 zhparser 的分词效果。
验证
换配置后重跑上面的 to_tsvector 与 ts_debug:中文串应当产出非空词位,ts_debug 的 alias 列应从 blank 变成 word。
装 zhparser / pg_jieba 需要额外编译,不装任何扩展也能当场验证:在同一个实例里建一个 UTF8 + en_US.utf8 的测试库(TEMPLATE template0,本文容器实测可用)——同一台机器、同一套扩展,只有编码与 lc_ctype 变了,正好单独验证上文"环境前提"的结论:
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c "CREATE DATABASE zh_probe TEMPLATE template0 ENCODING 'UTF8' LC_COLLATE 'en_US.utf8' LC_CTYPE 'en_US.utf8';"

# 重跑两条探针(注意 -d 换成 zh_probe)
docker exec ivorysql-ts140 psql -U ivorysql -d zh_probe -p 5432 -c \
  "SELECT to_tsvector('simple','pg_dump 逻辑备份与恢复') AS probe1;" -c \
  "SELECT to_tsvector('simple','逻辑备份与恢复') AS probe2;" -c \
  "SELECT alias, token, lexemes FROM ts_debug('simple','pg_dump 逻辑备份与恢复');"
本文容器实测:probe2 从空变成 '逻辑备份与恢复':1,ts_debug 里中文的 alias 从 blank 变成 word、lexemes 非空——中文产出词位了,这就是上文三环境表第三行的实测依据。同时注意:产出的词位是整个连续串,simple 词典不会把"逻辑备份与恢复"切开,只有整串完全相等才命中——真正的词典切词仍需 zhparser 这类扩展。验证完 DROP DATABASE zh_probe; 即可。
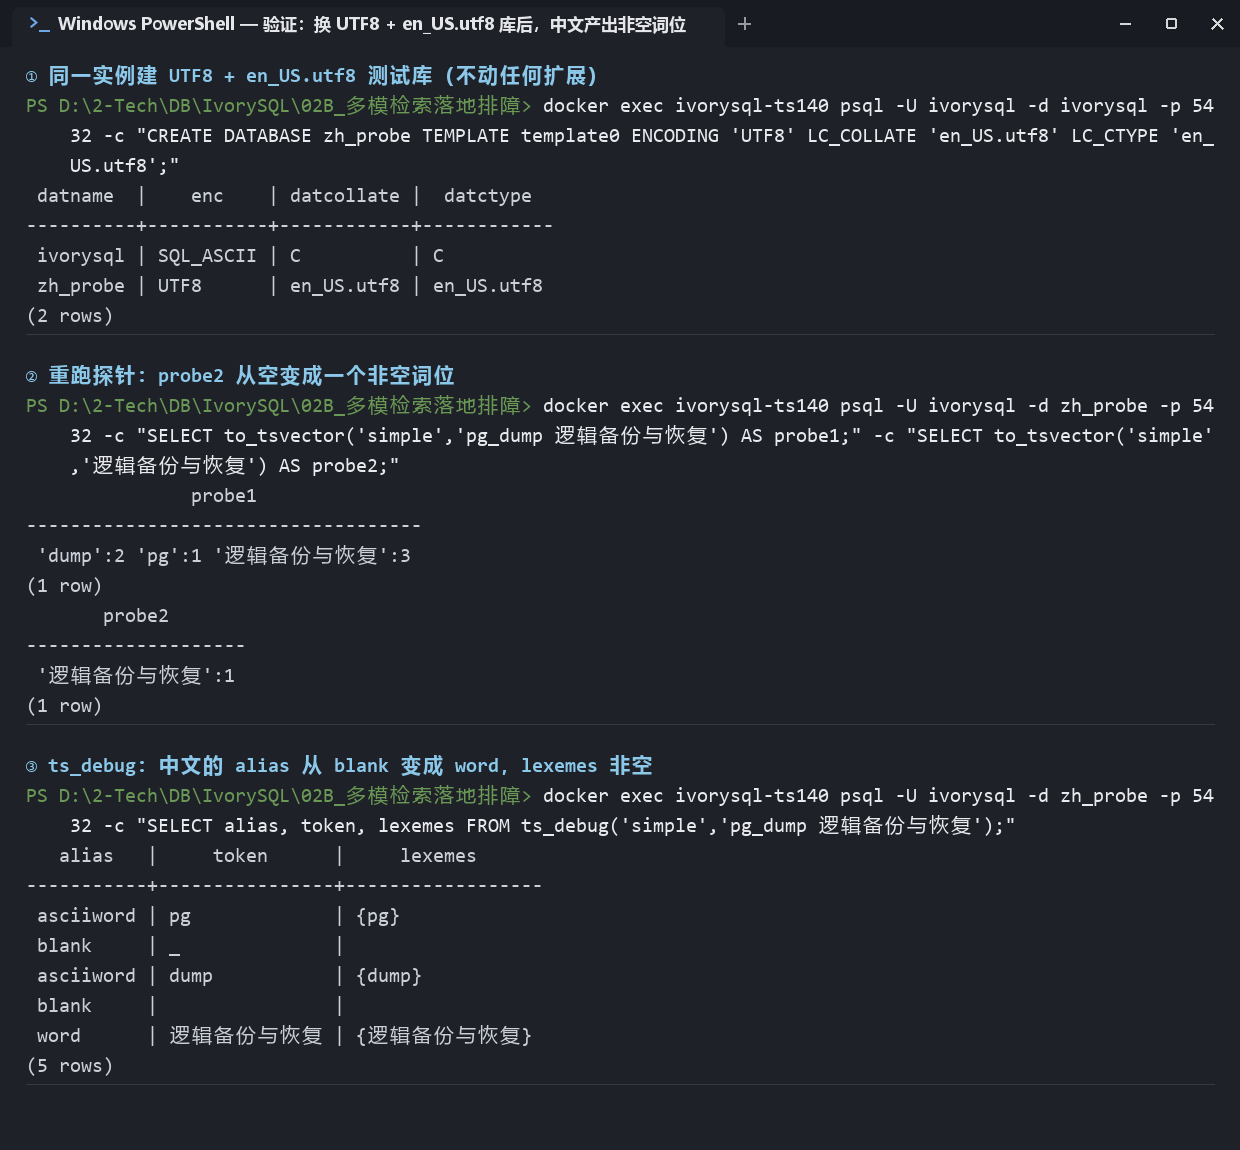
图 4:验证——同一实例、同一套扩展,只换库的编码与 lc_ctype,中文即从零词位变为产出词位
记住一句
simple 对中文不是"效果差",是"零产出"。上线前先 SELECT to_tsvector() 看一眼索引到底看见了什么,再谈检索质量。
三、坑 3:一个标量子查询,让 HNSW 索引白建
症状
先说"#2"是什么:kb_pgops 数据集一共 12 篇文档,主键 id 从 1 到 12,#2 就是 id=2 的那篇;"以 #2 为锚点找相似文档"是很常见的需求——先把这篇文档的向量从库里取出来,再拿它当查询向量,全表找最像它的 5 篇("看了这篇的人还看了……")。SQL 很自然会这么写(注意 -d 必须是装了 kb_pgops 的业务库 ivorysql;坑 2 里建的编码探针库 zh_probe 没有这张表,连错库只会得到 relation "kb_pgops" does not exist):
# 先直接执行锚点查询
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c "SELECT id FROM kb_pgops ORDER BY embedding <=> (SELECT embedding FROM kb_pgops WHERE id=2) LIMIT 5;"

# 再看执行计划(图 5 就是这条的输出)
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c "EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) SELECT id FROM kb_pgops ORDER BY embedding <=> (SELECT embedding FROM kb_pgops WHERE id=2) LIMIT 5;"
EXPLAIN (ANALYZE, BUFFERS) 里冒出一个 InitPlan,计划退化成了 Seq Scan + Sort——HNSW 索引在旁边看着,没被用上。
这棵计划树要分层读,别被里面的 Index Scan 迷惑(手工执行时最容易误判的地方):
Limit                                   ← 最外层:截断 5 行
  InitPlan 1                            ← 先独立执行的标量子查询:取 #2 的向量
    -> Index Scan using kb_pgops_pkey       走的是【主键 btree 索引】,Index Cond: (id = 2),只扫 1 行
  -> Sort                               ← 主检索路径:排序
       Sort Key: embedding <=> (InitPlan 1).col1
       -> Seq Scan on kb_pgops              12 行【全表扫描】后逐行算距离再排序
-
InitPlan 下面那个 Index Scan using kb_pgops_pkey 只是子查询"取锚点向量"时走了主键索引,跟向量检索无关;
-
真正干"找相似"活的主路径是 Sort → Seq Scan,全表 12 行一行不落;
-
判断 HNSW 用没用上,只看计划里有没有出现 kb_pgops_hnsw_idx 这个名字——没有,就是没用上。
根因
向量不是字面量、而是"运行期才算得出来的值"时,ORDER BY embedding <=> <标量> 无法被 HNSW 访问方法识别为可索引的排序表达式,规划器只能全表扫 + 排序。
同样的查询,把向量写成字面量(或绑定参数),计划立刻变成 Index Scan using kb_pgops_hnsw_idx。两者在 12 行小表上看不出快慢,百万行量级下是数量级的差距。
解法(按优先级)
首选(根治):应用层算好向量,用绑定参数 $1::vector 传入。 向量在规划阶段就确定,HNSW 索引接通,大表走 Index Scan。这是唯一能根治本坑的写法。两种写法差别只在查询向量怎么传:
-- ✗ 锚点写法:向量来自标量子查询,HNSW 用不上(本文复现的退化现场)
SELECT id FROM kb_pgops
ORDER BY embedding <=> (SELECT embedding FROM kb_pgops WHERE id = 2)
LIMIT 5;

-- ✓ 参数写法:向量在规划期已确定,HNSW 接通(应用层用 $1::vector 绑定)
SELECT id FROM kb_pgops
ORDER BY embedding <=> $1::vector
LIMIT 5;
如果"从库里取一篇当锚点"的需求去不掉,就在应用层分两步:先查出锚点向量,再以绑定参数回传做第二次查询,不要在一个 SQL 里套两层。
验证
对照计划:sql/02_vec_plan_check.sql 在同一会话里先出默认计划(Seq Scan + Sort,hit=6),再 SET enable_seqscan=off 出对照计划(Index Scan using kb_pgops_hnsw_idx,约 34 个缓冲区页),最后自动 RESET。一条命令跑完三段(PowerShell 5.1 不支持 < 重定向,外面套 cmd /c):
cmd /c "docker exec -i ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 < sql\02_vec_plan_check.sql"
本文实采的锚点写法计划(Sort Key 里明明白白写着 (InitPlan 1).col1):
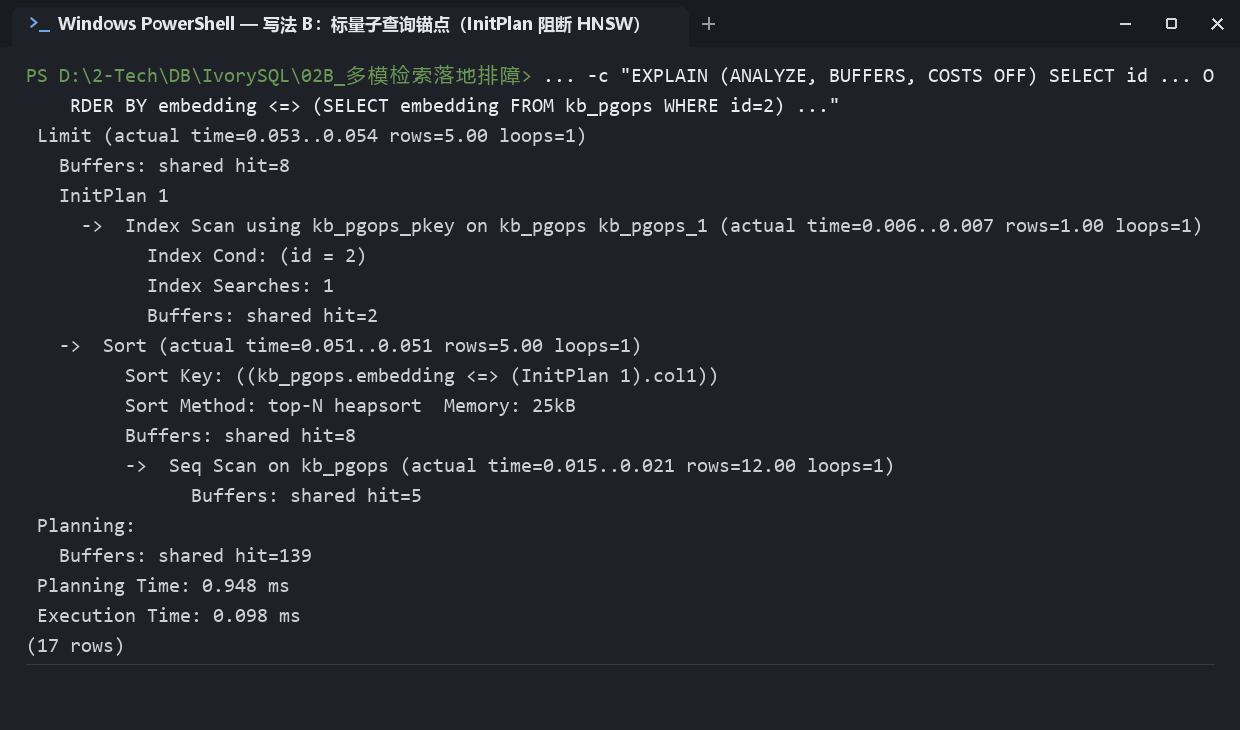
图 5:坑 3 实证——InitPlan 1 下的主键 Index Scan 只负责取 #2 的向量;主路径 Sort → Seq Scan 全表扫,全程没有出现 kb_pgops_hnsw_idx(Buffers 读数随缓存冷热小幅浮动,计划形态不会变)
记住一句
查询向量怎么传进 SQL,决定了 HNSW 到底能不能用。想"从库里取一条当查询"的写法,往往正好把索引废掉。
四、坑 4:w=1 不等于"走 BM25 索引扫描"
先说清楚 w 是什么:混合检索里,最终得分是两路分数相加——
总分 = w × BM25文本分 + (1 − w) × 向量相似度。
w 就是 BM25 和向量的配比系数:w=1 表示"结果分里 BM25 占 100%、向量分被乘 0 丢弃";w=0 表示"完全只看向量";w=0.3 表示 BM25 占 30%、向量占 70%。
它只决定两路分数怎么相加,并不决定 BM25 那一路走不走索引、也不决定没命中的行要不要参与排序。 下面这个坑,正是把这两件事搞混了。
症状
融合 SQL 里把权重设成 w=1(直觉上 = "完全听 BM25 的"),结果榜单出现 [2,3,4,5,1]——
Q3 的 BM25 明明只命中了 #2,后面那几位是怎么混进来的?注意:并列行的次序由物理存储决定,表一旦做过 VACUUM / UPDATE / INSERT,这个"并列内排名"就可能换人——它从根上就不稳定。
根因
很多人以为 w=1 会自动让数据库像独立 BM25 查询那样,"只返回命中关键词的文档"。这是两个完全不同层级的事:
| 你以为 w=1 会做的事 | 融合 CTE 里实际发生的事 |
|---|---|
| 自动只给命中行算分 | BM25 在 CTE 里是逐行函数,对全表 12 行每行都算 |
| 自动走 <@> 索引过滤掉无关行 | 走的是函数路径,没命中关键词的 11 行也照算,只是给 0.0 分 |
| 结果就等于独立 BM25 榜单 | #2 = 1.0,其余 11 行全是 0.0,全部并列 |
问题出在最后一步排序:ORDER BY 总分 DESC LIMIT 5 时——
-
#2 总分 1.0,稳拿第一;
-
剩下 11 行全是 0.0,并列。PostgreSQL 遇到并列,会按物理存储顺序(磁盘上行的实际位置)取前几个,而物理顺序不是 id 顺序,还会被 VACUUM / UPDATE / INSERT 打乱。
所以:榜单变成 [2,3,4,5,1] 是因为 #2 是冠军,后面 4 个是从 11 个 0.0 里按物理顺序抓出来的;静态表上连跑多次看着一样,但只要 VACUUM / UPDATE / INSERT 动过物理顺序,并列里被抓到的就是另一批。
1.4.0 实测复现(权重扫描 Q3):
w=0.0 : ids=[2, 3, 8, 6, 10] hits=3/3
w=0.3 : ids=[2, 3, 8, 6, 10] hits=3/3
w=0.5 : ids=[2, 3, 8, 6, 10] hits=3/3
w=0.7 : ids=[2, 3, 8, 6, 10] hits=3/3
w=1.0 : ids=[2, 3, 4, 5, 1] hits=2/3     ← 退化在这里
为什么 w=0 和 w=0.3 反而稳定?因为向量分那一路没有零分问题——12 行每行的相似度都不同,w 越小,向量分越能把行与行之间的差距拉开,就不会出现大量并列 0.0。只有 w=1 时向量系数被乘成 0,这个坑才暴露出来。
w 在代码里落在哪、怎么改成 1:手写融合 SQL 时,它就是最后打分那行的两个系数:
-- 通用形态:w 是 BM25 路系数,(1-w) 是向量路系数
round((w*b.ns + (1-w)*v.ns)::numeric, 4) AS hybrid_s
-- sql/04a_w1_zero_tie.sql 里的 w=1:BM25 系数 1.0、向量系数 0.0
round((1.0*b.ns + 0.0*v.ns)::numeric, 4) AS hybrid_s
-- 把两个系数换成 0.5/0.5 即 w=0.5
用配套脚手架时,w 是 build_sql(..., weight=w) 的入参,扫描档位 [0.0, 0.3, 0.5, 0.7, 1.0] 配在 code/experiment_kit/configs/kb_pgops_ts140.json 的 hybrid.weights 里,w=1.0 是扫描的边界一档。
什么场景真会把 w 设成 1:① 调试时临时退化成"纯关键词检索",拿 BM25 单路结果当对照基线;② 权重调参扫描扫到边界值 1.0(本文的退化现场正是这么扫出来的,见上面的权重扫描表);③ 业务上某些查询只信精确词(错误码、型号、SQL 关键字),主动关掉语义路;w=0 是对称的另一头(纯向量)。三种场景都合理,真正的坑是误以为"设成 w=1 就等价于独立 BM25 查询"——w 只改分数权重、不改候选集与执行路径,没命中的行照样以 0 分留在榜单里占坑(即上面对照表的三层差异)。
解法
零分候选保留还是丢弃,是融合 SQL 设计时必须显式写出来的策略,不能交给默认排序。 想让 w=1 严格等价于独立 BM25,就在 CTE 里显式过滤,只让真正命中的行参与融合。这里有一个必须实测才知道的细节:逐行函数路径下,没命中的行拿到的是 0.0 而不是 NULL(只有走 BM25 索引扫描时,未命中行才不出现、表现为 NULL),所以只写 IS NOT NULL 根本过滤不掉它们,必须把 0 分也剔掉:
-- 在 bm25_n 的来源处过滤,后续内连接时零分候选自然不参与融合
bm25_n AS (
  SELECT id, /* …min-max 归一化… */ AS ns
  FROM (SELECT * FROM bm25_r WHERE s IS NOT NULL AND s <> 0) b0
)
为什么可以用 s <> 0:pg_textsearch 的 BM25 分对命中行为负值、对零命中行为 0.0,命中行不可能恰好是 0;若你的语料里可能出现合法 0 分,改用 content @@ plainto_tsquery('simple', '查询词') 这类"是否命中"谓词更严谨。
验证
配套脚本连跑三段:① w=1.0 退化现场;② 加 s IS NOT NULL AND s <> 0 过滤后的修复结果;③ 独立 BM25 路对照。
想一次看完三段,跑合并版(PowerShell 用 cmd /c 重定向,避免中文编码问题):
cmd /c "docker exec -i ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 < sql\04_zero_score_tie.sql"
想逐段执行、逐步核对,下面三条命令分别对应三段(预期输出已标注,与图 6 的三个面板一一对应):
# ① w=1.0 退化现场:预期 5 行,榜单 [2,3,4,5,1],后四行 hybrid_s 全是 0.0000
cmd /c "docker exec -i ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 < sql\04a_w1_zero_tie.sql"

# ② 修复:预期只剩 1 行(id=2,bm25_n/vec_n/hybrid_s 都是 1.0000)
cmd /c "docker exec -i ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 < sql\04b_filter_fix.sql"

# ③ 独立 BM25 对照:预期只有 id=2、原始 BM25 分 -2.0694
#    (ORDER BY <@> 走 BM25 索引扫描,零命中文档不返回——与①的逐行函数路径正好形成对照)
cmd /c "docker exec -i ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 < sql\04c_bm25_only.sql"
本文容器实测(图 6):① 的榜单是 [2,3,4,5,1],后四位 hybrid_s 全是 0.0000;② 过滤后只剩 #2 一篇;③ 独立 BM25 也只返回 #2——修复后两路严格一致、重复执行稳定。
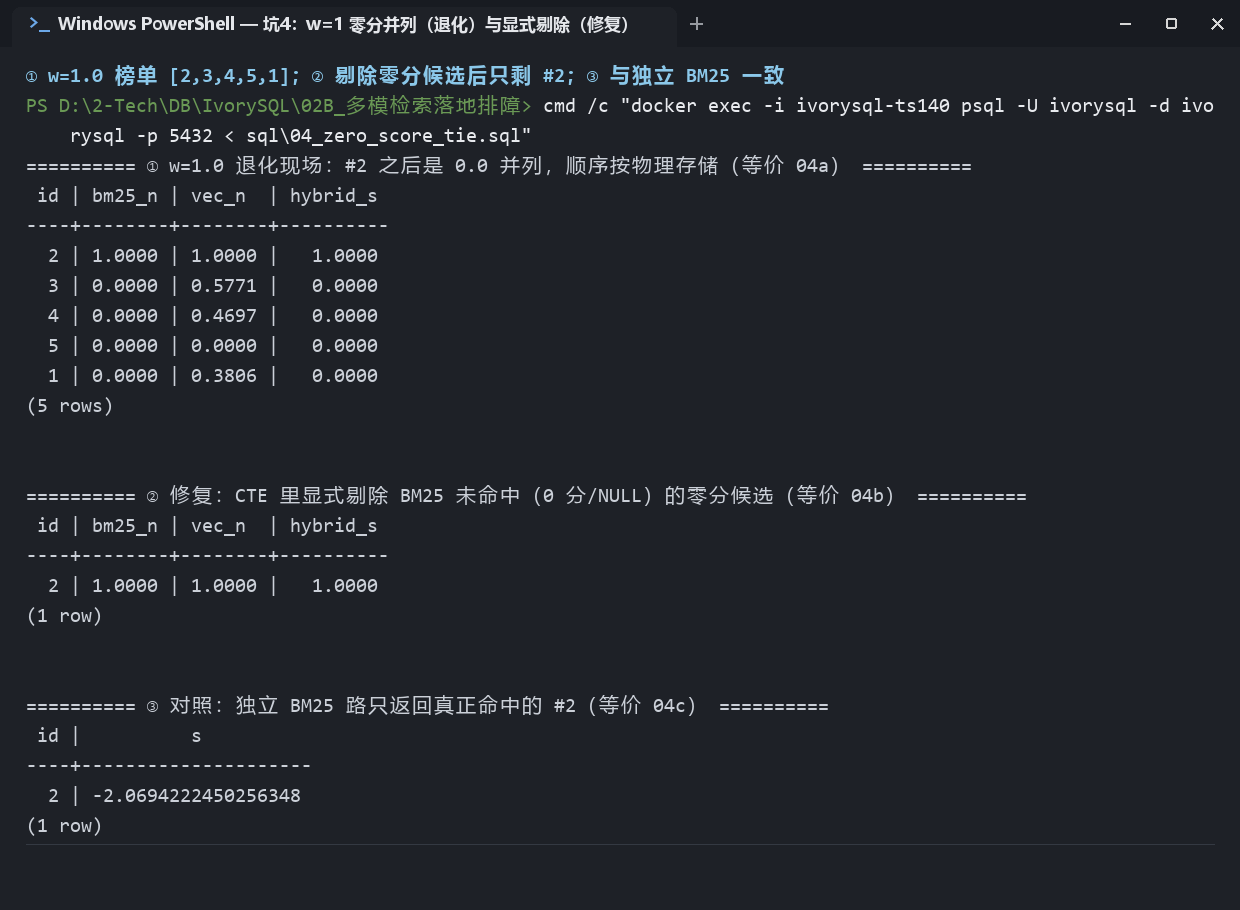
图 6:坑 4 实证——零分并列制造"假榜单",显式剔除后与独立 BM25 榜单一致
记住一句
融合不是把两路 SQL 拼起来就完事。"没命中的行给 0 分"和"没命中的行不参与",是两个完全不同的设计。
五、坑 5:建了 HNSW 却走 Seq Scan,idx_scan = 0
症状
建了 HNSW 索引(DDL 见 0.4,即 kb_pgops_hnsw_idx),EXPLAIN 里却是 Seq Scan;查 pg_stat_user_indexes,idx_scan = 0。
第一反应:"索引白建了 / 参数配错了"。
根因:这是规划器在帮你省钱
12 行小表上的实测对照(1.4.0 实采):
| 路径 | 计划 | Buffers |
|---|---|---|
| 向量(默认) | Seq Scan + Sort (top-N heapsort) | hit = 6 |
| 向量(强制 enable_seqscan=off) | Index Scan using kb_pgops_hnsw_idx | hit = 34 |
| BM25 | Index Scan using kb_pgops_bm25_idx | hit = 32 |
全表算 12 次余弦距离只需访问 6 个共享缓冲区页;走 HNSW 要访问约 34 个页(含回表),反而更贵。
这不是"索引没用",是"这次全表更便宜"。
想亲眼对照,跑坑 3 那份脚本即可(前两段就是本节内容):
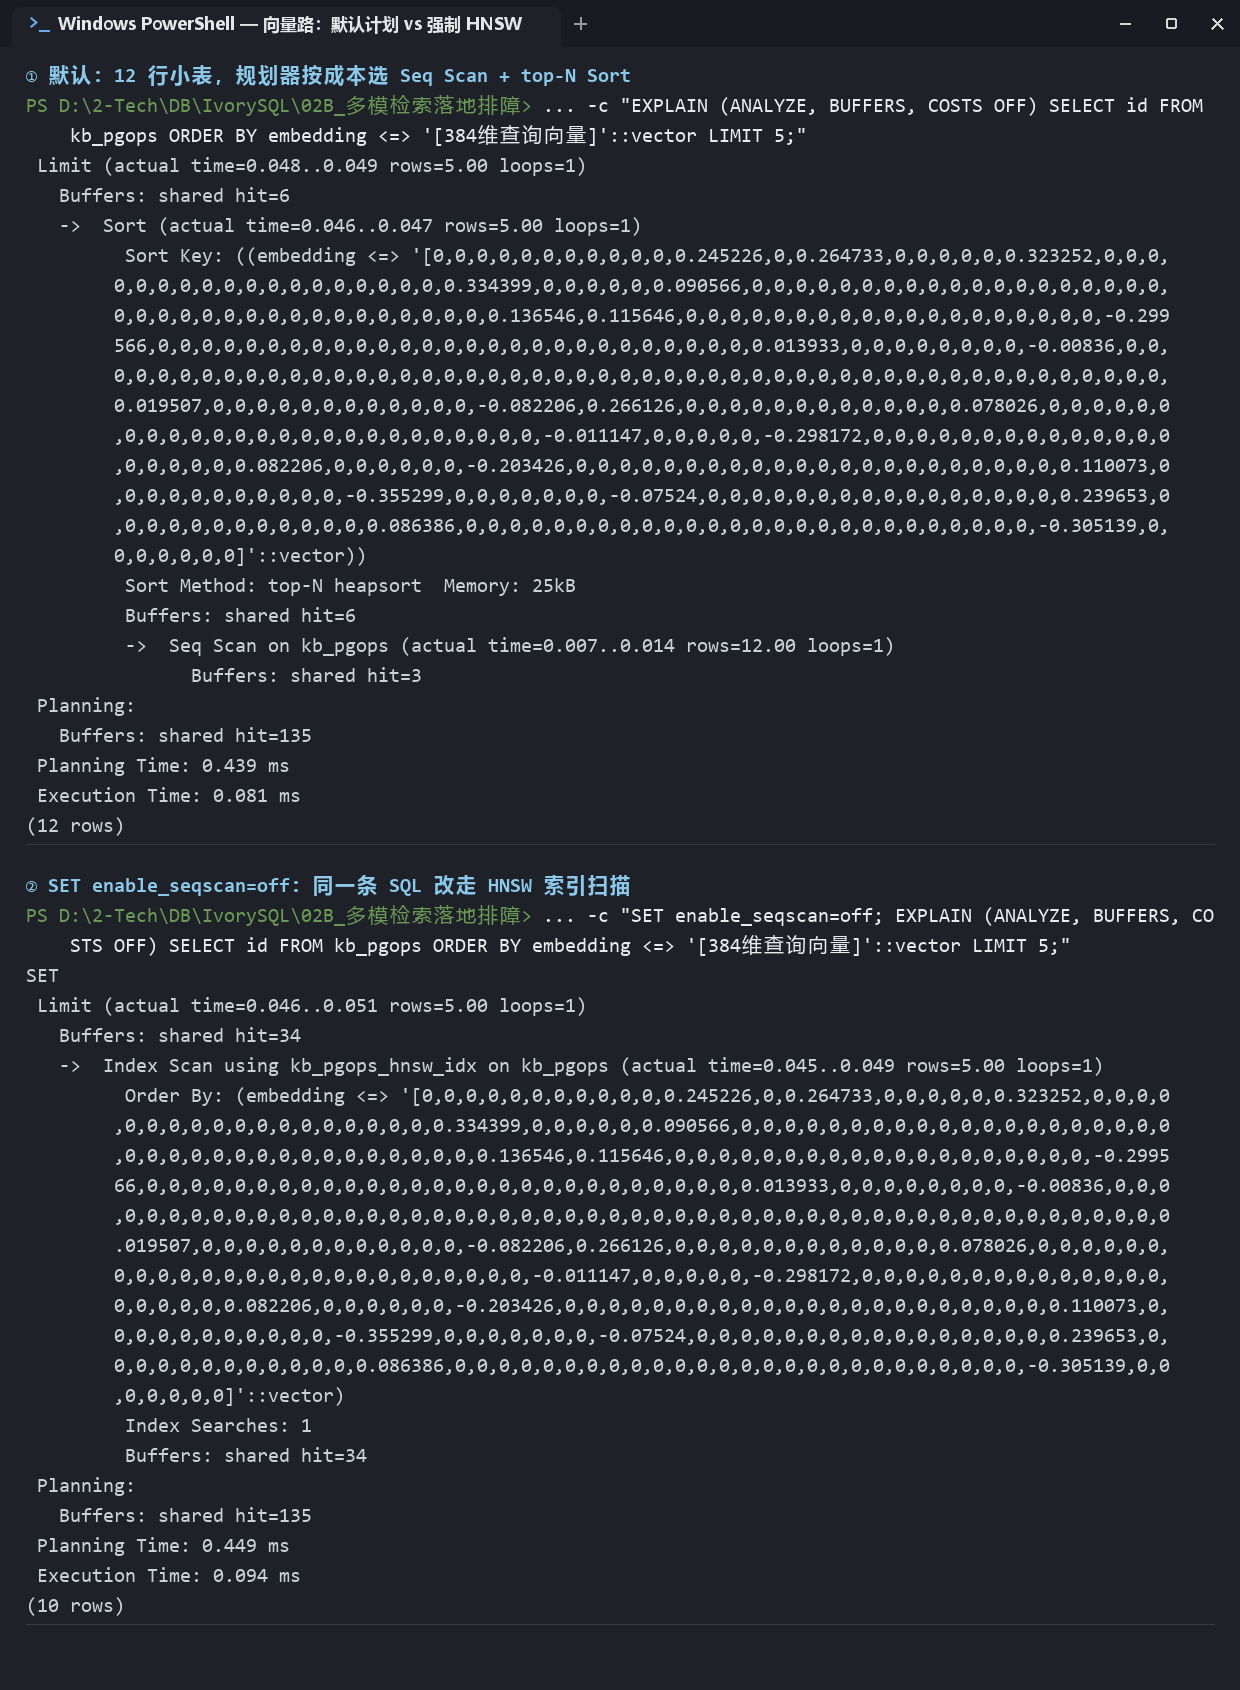
cmd /c "docker exec -i ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 < sql\02_vec_plan_check.sql"
图 7:坑 5 实证——规划器选 Seq Scan 是因为访问的缓冲区页更少(6 vs 约 34)
一个有意思的实测旁证——本文容器的 idx_scan 计数:
 kb_pgops_bm25_idx |  42    ← BM25 查询基本都走索引
 kb_pgops_hnsw_idx |   8    ← 仅有的几次都来自对照实验里手动 SET enable_seqscan=off
 kb_pgops_pkey     |  44
idx_scan 是累计计数器,数值随容器执行历史只增不减(你复现时几乎不会正好是 42/8/44);要看的是对比关系:自然查询下 HNSW 扫描次数长期接近 0。
不是索引坏了,是规划器算过账。
Buffers 别当固定常数:它随索引物理大小、缓存冷热浮动(同一索引 REINDEX 前后、容器刚启动与运行一段时间,读数都会变)。看计划形态(走没走索引),别背具体数字。
解法
不用解。 要做的只有两件事:
-
小表上坦然接受 Seq Scan;
-
数据量上来后用 EXPLAIN 复核是否切换,不要凭感觉强制走索引。
若一定要验证 HNSW 可用(比如坑 3 的对照实验),SET enable_seqscan=off 临时验证,验证完记得 RESET——别把这开关留在生产会话里。
记住一句
idx_scan = 0 在小表上是正常的。规划器是个会算账的管家,它选 Seq Scan 是因为这样更便宜。
六、坑 6:HNSW 维护与容量预算
6.1 维护:三条实测结论
| 流传的说法 | 实测结论 |
|---|---|
| "新行有查不到的窗口期" | 错。pgvector 0.8.5 的 HNSW 支持增量维护,INSERT/UPDATE/DELETE 无需 REINDEX,新行立刻能搜到。这是 0.5.0 之前 IVFFLAT 的老黄历。 |
| "定期 REINDEX 保养" | 错。REINDEX 是 O(N log N) 的重活,只在改维度、换 m/ef_construction、图质量明显劣化时做。线上用 REINDEX INDEX CONCURRENTLY。 |
| "改 embedding 维度" | 必须重建索引,没有 ALTER 路径。 |
另外三条实用经验:
-
死节点靠 VACUUM 回收:更新/删除在图里留死节点,不影响正确性(扫描时跳过)但占空间;大批量写入后可手动 VACUUM (ANALYZE) 表名;
-
大批量建索引提速:会话内 SET maintenance_work_mem='4GB'; SET max_parallel_maintenance_workers=4;,建完恢复;
-
检索侧 GUC(0.8.5 实测):hnsw.ef_search(默认 40)、hnsw.iterative_scan(改善带过滤条件的召回)、hnsw.max_scan_tuples(默认 20000)。
6.2 容量:公式会低估,维度换算就是"翻倍即翻倍"
实测锚点(同一容器、同一建索引参数 m=16, ef_construction=64,每种维度各造 1 万行):
| 维度 | 1 万行 HNSW 索引 | 折合每行 | 外推 100 万行 |
|---|---|---|---|
| 384(实测) | 20 MB | 2048.8 B/行 | ≈ 1.91 GiB |
| 768(实测) | 39 MB | 4096.8 B/行 | ≈ 3.82 GiB |
| 1536(实测) | 78 MB | 8192.8 B/行 | ≈ 7.63 GiB |
本文 12 行表上三个索引的实测体积,一条 psql 元命令即可复现(图 8):
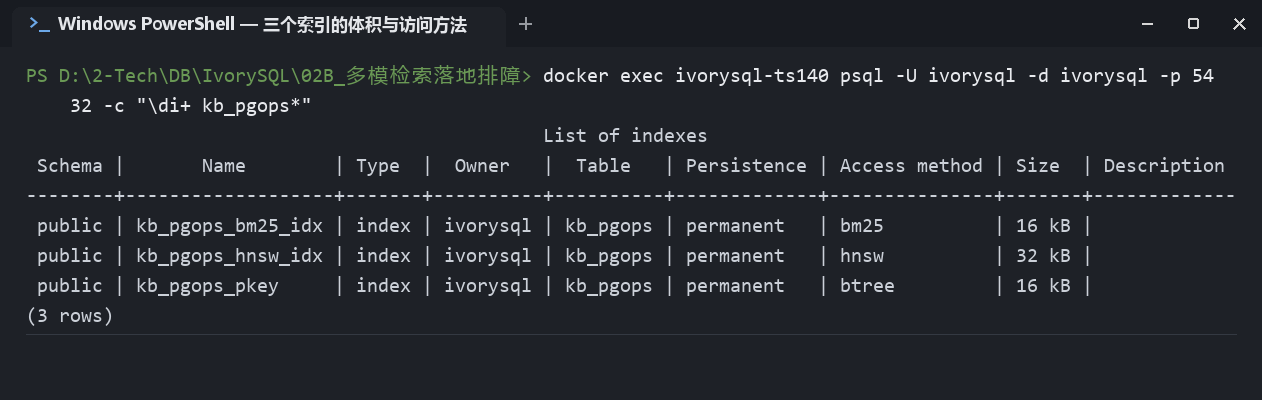
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c "\di+ kb_pgops*"
图 8:bm25 / hnsw / btree 三种访问方法的体积实测
为什么不能直接套公式:理论口径是向量本体 4 × 维度 + 8 = 1544 B/行(384 维),加图链接经验值 150300 B/行 ≈ 16941844 B/行,比实测 2048.8 B偏低约 10~20%。差额来自页内开销、多层图结构与索引 tuple header。
维度换算:实测的结论是"维度翻倍、每行字节数也翻倍"。
这一点非常容易想错。直觉上会觉得"只有向量本体(4 B/维)随维度增长,图链接那些是固定开销",所以维度翻倍时容量应该只涨一部分——实测不是这样。上面三档的字节数是 2048.8 → 4096.8 → 8192.8,系数稳定在约 5.33 B/维;把向量本体扣掉后,剩余开销是 504.8 / 1016.8 / 2040.8 B,它自己也在随维度涨(约 1.3 B/维)。原因是行变宽之后,页内对齐、tuple header 与多层图的存储开销同样被放大了。
所以估容量就按"维度翻倍、容量翻倍"估,这既保守也最接近实测。千万别用只算向量本体的口径,那会低估 20% 以上。
顺带一个现场提醒——1536 维才 1 万行,建索引时就撞上了这个:
NOTICE:  hnsw graph no longer fits into maintenance_work_mem after 9665 tuples
DETAIL:  Building will take significantly more time.
HINT:  Increase maintenance_work_mem to speed up builds.
维度越高、行数越多越容易触发。建索引前先按 §6.1 把 maintenance_work_mem 调大,别等它慢下来了才发现。
预算建议:
-
按维度取每行字节数:384 维 2048.8 B / 768 维 4096.8 B / 1536 维 8192.8 B(m=16 口径)。384 维下 100 万行 ≈ 1.91 GiB、1000 万行 ≈ 19 GiB
-
其他维度用 5.33 B/维 × 维度 粗估,或按下面的办法实测
-
建索引期间需要额外临时空间(受 maintenance_work_mem 影响)
-
生产预留估算值的 1.5~2 倍
-
BM25 倒排索引体积取决于语料 token 总量,不能按行数套,必须实测
最准的办法:造一张 N 行同维度的表,CREATE INDEX 后 SELECT pg_relation_size('索引名')/N 即得每行真实字节数。脚本见 code/probe_capacity.sql(384 维);上面三档维度的对照实测见 code/probe_capacity_dims.sql。
记住一句
HNSW 的维护负担比想象中轻(增量可见),但磁盘负担比公式算出来的重(实测高 10~20%),而且维度翻倍、容量就翻倍——别只算向量本体那部分。
七、坑 7:上线后没得看——监控基线从零开始搭
7.1 pg_stat_statements:镜像里有,但默认没开
先查它在不在(可直接复制执行):
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c "SELECT name, default_version, installed_version FROM pg_available_extensions WHERE name='pg_stat_statements';"
本文容器实测输出——注意:"有一行返回"不等于"已经启用":
name        | default_version | installed_version
--------------------+-----------------+-------------------
 pg_stat_statements | 1.12            |
(1 row)
default_version = 1.12 只说明镜像里带着这个 contrib 模块;installed_version 是空的才是关键——它表示"可用但尚未 CREATE EXTENSION"。再看一眼预加载名单,里面同样没有它:
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c "SHOW shared_preload_libraries;"
# 实测:gb18030_2022, liboracle_parser, ivorysql_ora, pg_textsearch(没有 pg_stat_statements)
它属于 contrib,必须先出现在 shared_preload_libraries 里才能工作。启用三步:
- 把 pg_stat_statements 追加进容器内 ivorysql.conf 的 shared_preload_libraries(保留原有项)
2. docker restart ivorysql-ts140
3. CREATE EXTENSION pg_stat_statements;
启用后它能回答"哪条 SQL 累计最耗时、哪个查询吃 buffer 最多"。多模检索这种每毫秒都要算钱的场景,没它等于闭眼开车。生产必开。
7.2 死元组与索引使用率
-- 死元组比例(写入型表重点看)
SELECT relname, n_live_tup, n_dead_tup, n_tup_upd, n_tup_del,
       round(100.0 * n_dead_tup / NULLIF(n_live_tup + n_dead_tup, 0), 2) AS dead_pct
FROM pg_stat_user_tables WHERE relname = 'kb_pgops';

-- 索引被用了多少次
SELECT indexrelname, idx_scan, idx_tup_read, idx_tup_fetch
FROM pg_stat_user_indexes WHERE relid = 'kb_pgops'::regclass;
经验阈值:
| 触发条件 | 动作 |
|---|---|
| dead_pct > 10% | 手动 VACUUM ANALYZE |
| dead_pct > 20% | 低峰评估 VACUUM FULL(持表锁)或在线重建 |
| 小表 idx_scan = 0 | 正常,见坑 5;大表持续为 0 才需要排查 |
7.3 一条巡检清单
串成定时任务(完整脚本见 sql/03_monitor.sql):
-
canary 探针(见附录 D)——BM25 索引返回 0 行即告警,这是发现"查询异常"最快的手段
-
索引状态 indisvalid/indisready/indislive —— 注意它正常不代表算得对
-
死元组比例 —— 阈值 10% / 20%
-
索引使用率 —— 小表 idx_scan=0 属正常,大表持续为 0 才需要查
-
TOP 10 慢查询 —— 需先启用 pg_stat_statements
记住一句
多模检索的故障大多是"静默"的——不报错、不崩、只是慢慢不准。没有巡检,你会在很久以后才发现。
八、如果只记三件事
7 个坑末尾各有一句"记住一句";下面三条是最容易直接造成线上事故或评测失真的点(覆盖坑 3、坑 5、坑 6 与附录 D),其余坑回看 0.3 速览表即可。
-
查询向量怎么传,决定 HNSW 生不生效。 绑定参数进得去,标量子查询进不去(坑 3)。
-
规划器选 Seq Scan 是在帮你省钱,别急着改参数。 但容量要按实测每行字节数算,公式会低估 10~20%(坑 5、坑 6)。
-
巡检要覆盖"查询结果"而不只是"索引状态"。 系统目录说索引活着,不代表它算得对(见附录 D)。
附录 A:12 行最小对照实验(可选)
七个坑都不依赖这个实验。如果你想知道"BM25 和向量到底谁召回得好",可以用这套最小集跑一遍——但请先看完这段声明。
A.1 能证明什么、不能证明什么
| 能证明 | 融合机制如何工作、执行计划形态、运维代价(确定可复现) |
| 不能证明 | ① 向量天然优于 BM25——本文 384 维向量是 token-hash 构造,不是语义模型;② 混合提升了召回率——实测向量与混合的 gold 命中同为 9/9(口径见下); ③ 任何"能力评测"——5 个查询的 gold 由作者按内容自标,共 9 个标注点(Q2、Q3 各含 3 个相关文档),且恰好全部落在向量 Top-5 内,9/9 是标注结构的数学必然 |
所以 Recall@5(即"前 5 个结果里的命中率";本文 5 个查询共 9 个 gold 标注点、全部落在 Top-5 = 9/9)这一列只能读成"机制演示的一致性验证",不能读成能力得分。 想做真正的能力评测,请换外部标准数据集(如 BEIR / MTEB 公开子集 + 官方 qrels)。
A.2 怎么跑
# ① 建表 + 灌入 12 篇短文 + 建双索引(先把脚本拷进容器,文件位置见附录 B)
docker cp code/kb_pgops_init.sql ivorysql-ts140:/tmp/
docker exec -i ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -f /tmp/kb_pgops_init.sql

# ② 一键跑完五查询三路对比 + 权重扫描
cd code/experiment_kit
python run_all.py --config configs/kb_pgops_ts140.json
约 1 分钟后在 results/<时间戳>/article_tables.md 得到全部表格。零三方依赖,Python 3 标准库即可。
本文 1.4.0 实测关键自检点(读者复跑时应得到相同结果):
Q5: bm25 top3=[11,6,7] / vec #11 第3位 / hybrid #11 第1位
权重扫描 Q3 w=1.0 : ids=[2, 3, 4, 5, 1] hits=2/3   ← 坑 4 的现场
A.3 换成你的数据
抽 8 条以上真实业务查询重跑:
-
BM25 也接近全中 → 查询以精确术语为主,向量侧可以省
-
只有 50~70% → 混合的收益值得投入
这一步只有你能做,因为真实查询语料在你手里。
A.4 评测设计的三条纪律:让结论经得起别人复跑
这三条是本文设计实验时实际用来"卡住自己"的检查项,也是读者给自己的多模检索实验做体检、或评审他人评测报告时可以直接逐条对照的清单。
| 纪律 | 对应的陷阱 | 可直接照做的自查动作 |
|---|---|---|
| ① 先查 gold 与各路 Top-K 的交集,再谈命中率 | gold 若全部落在某一路的 Top-K 内,那一路的"满分"只是标注结构的产物、不是能力证据(本文 A.1 的 9/9 = 5 查询 9 个 gold 点全中,即属此类,已主动降级为"机制一致性验证") | 把 gold 集合与每一路 Top-K 求交集;若某一路交集 = 全部 gold,该路命中率不得作为能力结论,需换外部标准数据集(见 A.1 末尾) |
| ② 说"提升倍数"必须写明参照系 | 同一组数据下,"混合是 BM25 的 2 | 倍数统一写成"相对 X 路提升 N 倍",并在同一张表里给出各路基线分,让读者自己能验算 |
| ③ 把"结构一致"和"数值一致"分开验收 | Buffers 命中数、idx_scan 这类值随索引物理大小、缓存冷热、累计计数浮动;写进"必须逐位一致"清单,读者一复跑对不上,就会连带怀疑全部结论 | 验收清单分两栏:计划形态、榜单 id 序列要求完全一致;Buffers/计数器只要求同一数量级,并注明浮动口径(本文各图注均已这样标注) |
一句话:评测的可信度不来自漂亮的数字,而来自别人按你的步骤复跑时,清楚知道哪些结果必须一样、哪些本来就会浮动。
附录 B:文件清单
配套文件已开源于 GitHub,读者可克隆后按上表相对路径取用:
仓库:https://github.com/markboluo26330/ivorysql-multimodal-series
克隆:git clone https://github.com/markboluo26330/ivorysql-multimodal-series.git
重跑 make_shots.py 需 Python 3 + Pillow / matplotlib。
| 文件 | 用途 |
|---|---|
| sql/00_env_check.sql | 环境自检:扩展版本、预加载配置 |
| sql/01_canary_probe.sql | canary 探针 + 索引状态 + REINDEX(附录 D 核心,巡检必配) |
| sql/02_vec_plan_check.sql | 写法 A / 写法 B 执行计划对照(坑 3、坑 5) |
| sql/03_monitor.sql | 死元组、索引使用率、慢查询(坑 7) |
| sql/04_zero_score_tie.sql | 坑 4 三段连跑版(图 6 一次出齐) |
| sql/04a_w1_zero_tie.sql | 坑 4 第①步:w=1 退化现场,可单独执行 |
| sql/04b_filter_fix.sql | 坑 4 第②步:显式剔除零分候选后的修复版 |
| sql/04c_bm25_only.sql | 坑 4 第③步:独立 BM25 路对照 |
| code/kb_pgops_init.sql | 12 篇短文数据集 + 双索引 |
| code/probe_capacity.sql | HNSW 每行字节数实测(坑 6,384 维) |
| code/probe_capacity_dims.sql | 384 / 768 / 1536 三档维度容量对照实测(坑 6 换算依据) |
| code/experiment_kit/ | 一键对比脚手架(附录 A,可选;kb_pgops_ts140.json 指向 1.4.0 容器) |
| figures/ | 本文 9 张配图(全部采自 1.4.0 容器) |
| make_shots.py | 配图采集脚本,可重跑重截(需 Python + Pillow / matplotlib) |
| 06_生产级部署_Dockerfile/ | 生产级部署 Dockerfile(附录 C 构建用,从官方镜像全量编译多模扩展) |
| 版本对照_pg_textsearch_0.6.1_vs_1.4.0.md | 两版逐项对照的完整实测记录 |
附录 C:环境复现
C.1 推荐路径:从官方镜像全量构建(任何人都能跑通)
本路径的基础镜像是 IvorySQL 官方公开镜像 registry.highgo.com/ivorysql/ivorysql:5.4-ubi8,不依赖任何本地私有镜像,换台机器一样能复现。构建过程中会依次编译 pgvector 0.8.5、Apache AGE、pg_bigm 与 pg_textsearch 1.4.0,耗时约 2~15 分钟(视网络与机器性能)。
# ① 构建(Dockerfile 位于本仓库的 06_生产级部署_Dockerfile/ 目录)
cd 06_生产级部署_Dockerfile
docker build -f Dockerfile -t ivorysql-kb:pg18-ts140 .

# ② 启动
docker run -d --name ivorysql-ts140 -p 5436:5432 \
  -e IVORYSQL_PASSWORD=Test@2026 ivorysql-kb:pg18-ts140

# ③ 建扩展 + 灌数据
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 \
  -c "CREATE EXTENSION pg_textsearch;" -c "CREATE EXTENSION IF NOT EXISTS vector;"
docker cp code/kb_pgops_init.sql ivorysql-ts140:/tmp/
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -f /tmp/kb_pgops_init.sql
该镜像默认预加载四扩展(age 也在内)。本文容器为最小集(多模扩展只预加载 pg_textsearch,不含 age)——两者对本文全部结论没有影响,坑 1 的实测值以你自己的 SHOW shared_preload_libraries 为准。
C.2 可选路径:只重编 pg_textsearch(版本对照用)
如果你已按本系列上篇(系列一)构建过 ivorysql-kb:pg18 镜像,可以用增量 Dockerfile 只重编 pg_textsearch,几十秒出结果,便于做 0.6.1 / 1.4.0 的版本对照:
docker build -f Dockerfile.ts_version -t ivorysql-kb:pg18-ts140 .                      # 1.4.0(默认)
docker build -f Dockerfile.ts_version --build-arg TS_VERSION=v0.6.1 \
  -t ivorysql-kb:pg18-ts061 .                                                            # 复现旧版故障
注意:该 Dockerfile 的 FROM 是本地镜像 ivorysql-kb:pg18,没有这个基础镜像会构建失败。首次复现请走 C.1。
关于命令执行方式:本文命令均在 Windows PowerShell 5.1 下实测。PowerShell 5.1 不支持 < 输入重定向,喂 .sql 文件统一套一层 cmd /c "docker exec -i ... < 文件"(正文与截图均为此写法,中文不乱码);也可以先 docker cp 进容器再用 -f 执行。Linux / macOS / Git Bash 直接 < 重定向即可。
附录 D:一个已经被新版本修掉的坑
这一节记录 0.6.1 上的一个真实故障。它在 1.4.0 上已复现不出,但保留价值有三:
给还在用 0.x 的读者一个完整的排障样本;说明 canary 探针为什么值得配;以及一个朴素道理——prerelease 的警告不是吓唬人的。
症状:索引状态全 t,查询却返回 0 行
0.6.1 容器持续运行、跨重启之后:kb_pgops_bm25_idx 在系统目录里一切正常——
SELECT indisvalid, indisready, indislive FROM pg_index
WHERE indexrelid='kb_pgops_bm25_idx'::regclass;
-- t | t | t
但索引扫描对所有查询返回 0 行。
更隐蔽的是混合路不报错,只是分数悄悄漂移:融合 CTE 里 BM25 走逐行函数路径还在出分,但语料统计已经错了——实测出现过「不含 pg_dump 的文档被打出 -2.1401 的分」。这种漂移没有任何告警。
根因:0.6.1 的内存架构
0.6.1 是纯内存倒排索引,重启后从堆表重建,重建路径在部分场景下不可靠——这也是官方当时给出的警告所指的那类风险:
WARNING: pg_textsearch v0.6.1 is a prerelease. Do not use in production.
pg_textsearch 1.0 把架构整个重写成了「内存 memtable + 磁盘 segment」(LSM 式),索引随 WAL 持久化。这正是本次升级对照里唯一"消失"的坑——1.4.0 容器连续重启两次,canary 探针稳定返回 id=1,五个查询的打分与重启前逐位一致。
排障手段今天依然有用
发现——为每个 BM25 索引配 2~3 条"已知必有结果"的探针,纳入定时巡检:
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c \
  "SELECT id FROM kb_pgops ORDER BY content <@> 'pg_dump 备份' LIMIT 1;"
返回 0 行(而不是 id=1)= 检索出了问题,立即告警。 完整巡检脚本见 sql/01_canary_probe.sql。
巡检基线(1.4.0 实测:探针 id=1、索引状态三个 t、死元组 0%、hnsw_idx 的 idx_scan 长期接近 0——最后这个正是坑 5 的正常现象;计数器只增不减,具体数值以你自己的环境为准,见图 9):
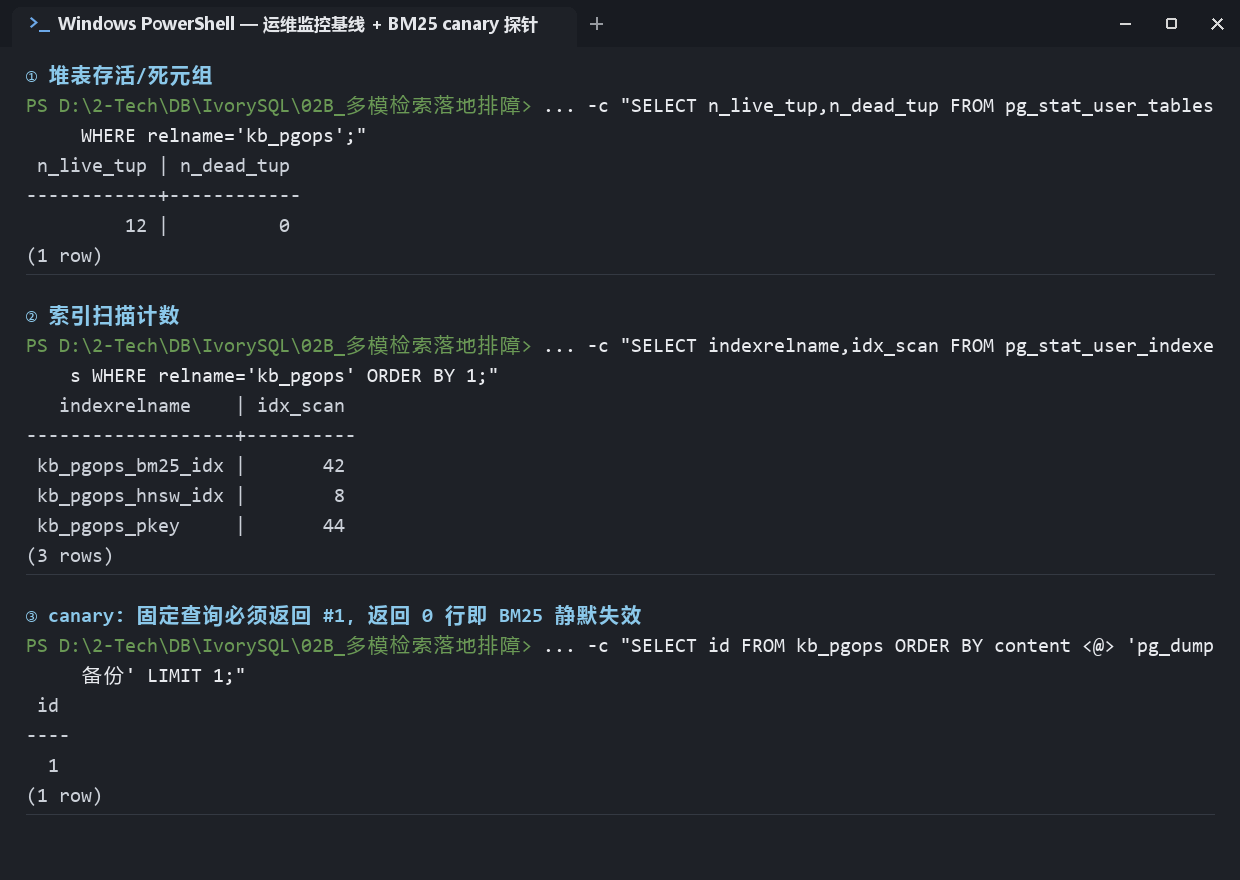
图 9:巡检基线(对应 sql/01_canary_probe.sql + sql/03_monitor.sql)
恢复(0.x 上有效)——REINDEX(本数据规模秒级完成):
docker exec ivorysql-ts140 psql -U ivorysql -d ivorysql -p 5432 -c \
  "REINDEX INDEX kb_pgops_bm25_idx;"
-- 预期 NOTICE:BM25 index build completed: 12 documents, avg_length=11.75
生产上用 REINDEX INDEX CONCURRENTLY 避免长时间持锁。
顺带一个实测结论:不存在 VACUUM INDEX 这个语法(会报错)。BM25 是自定义访问方法,维护靠表级 VACUUM/autovacuum,重建靠 REINDEX [CONCURRENTLY]。
两条教训(不随版本失效)
-
索引健康不能只看 indisvalid。 系统目录说它活着,不代表它算得对。必须配探针。
-
两条路径的故障模式不同,监控要分别覆盖:独立 BM25 路坏了 → "查不到"(容易发现);混合路坏了 → "分数悄悄变"(更危险,且没人报警)。
本文所有数字均来自 ivorysql-ts140 容器(IvorySQL 5.4 + pg_textsearch 1.4.0 + pgvector 0.8.5)实测,最近一次采集日期 2026-09-14;0.6.1 专属现象已集中在附录 D 并标注。
8 个配套 SQL 脚本与 9 张配图均在该环境完整执行/采集通过,复现步骤见附录 C。
术语表
| 术语 | 含义 |
|---|---|
| gold(标准答案集) | 信息检索评测中人工标注的"某查询应当命中的正确文档"集合。本文 5 个查询共标注 9 个 gold 点(Q2、Q3 各含 3 篇相关文档,其余查询各 1 篇)。 |
| Top-K | 检索返回结果里排名最前的 K 个。本文所有评测取 K=5。 |
| Recall@K(召回率@K) | 前 K 个结果里命中的标准答案数 ÷ 标准答案总数。本文 5 个查询的 9 个 gold 点全部命中 = 9/9。 |
| 混合检索 | 向量语义召回与 BM25 关键词召回分别求得结果、再融合排序的检索方式(本文坑 4 与附录 A 涉及)。 |
| qrels | 标准相关性判定文件,记录"查询—文档—是否相关";外部评测基准(如 BEIR / MTEB)自带。 |
| BEIR / MTEB | 公开的检索 / 嵌入模型评测基准集合;想做严肃能力对比时用作外部标准数据集(见附录 A)。 |